6 เทคนิคคุม Token ให้องค์กรประหยัดงบ AI ได้ถึง 75% (เรียงลำดับจากง่ายไปยาก)
ผู้เขียน: ทีมยุทธศาสตร์เทคโนโลยี AuthorWise
หมวดหมู่: AI FinOps, Enterprise Technology, Cloud & Infrastructure, Cost Optimization
กลุ่มเป้าหมาย: CEO, CFO, CIO, CTO, Enterprise Architects, IT Directors, Heads of AI/Data
ในช่วงเริ่มต้นที่องค์กรทดลองใช้งาน AI ผ่านโครงการนำร่อง (PoC) ที่มีผู้ใช้งานเพียง 5 - 10 คน บิลค่าใช้จ่าย API สิ้นเดือนมักอยู่ที่หลักพันถึงหลักหมื่นบาท ซึ่งดูเหมือนเป็นงบประมาณที่ไม่น่ากังวล...
แต่ทันทีที่องค์กรก้าวข้ามจาก Prototype สู่ Production Scale เปิดให้พนักงานหลายร้อยหลายพันคนใช้งานในชีวิตประจำวัน จนเกิดธุรกรรมวันละหลายหมื่น Transaction สิ่งที่ CFO และ CIO มักต้องเผชิญหน้าคือ "ภาวะบิลช็อก (Surprise Bill)" ที่ค่า Token พุ่งสูงขึ้นแตะหลักแสนหรือหลักล้านบาทอย่างไร้การควบคุม จนบอร์ดบริหารต้องสั่งชะลอโครงการ AI ลงอย่างน่าเสียดาย
สาเหตุหลักไม่ได้เกิดจากโมเดล AI มีราคาแพงเกินไป แต่เกิดจาก "การใช้เครื่องมือผิดประเภทและขาดการวางสถาปัตยกรรมควบคุมต้นทุน" หรือที่เรามักเปรียบเทียบว่าเป็นการ "ขี่ช้างจับตั๊กแตน" เช่น การปล่อยให้พนักงานหยิบโมเดลระดับเรือธงตัวท็อป (เช่น GPT-4o หรือ Claude 3.5 Sonnet) ไปรันงานง่ายๆ อย่างการจัดหมวดหมู่อีเมล หรือการสรุปข้อความสั้นๆ 3 บรรทัด
ในบทความนี้ AuthorWise จะมาเปิดคัมภีร์ AI FinOps: 6 เทคนิคการคุม Token ให้องค์กรประหยัดค่าใช้จ่ายได้สูงสุดถึง 75% โดยเรียงลำดับตั้งแต่ขั้นตอนที่ ง่ายที่สุดที่เริ่มทำได้ทันที ไปจนถึง การวางโครงสร้างพื้นฐานระยะยาวแบบยั่งยืน
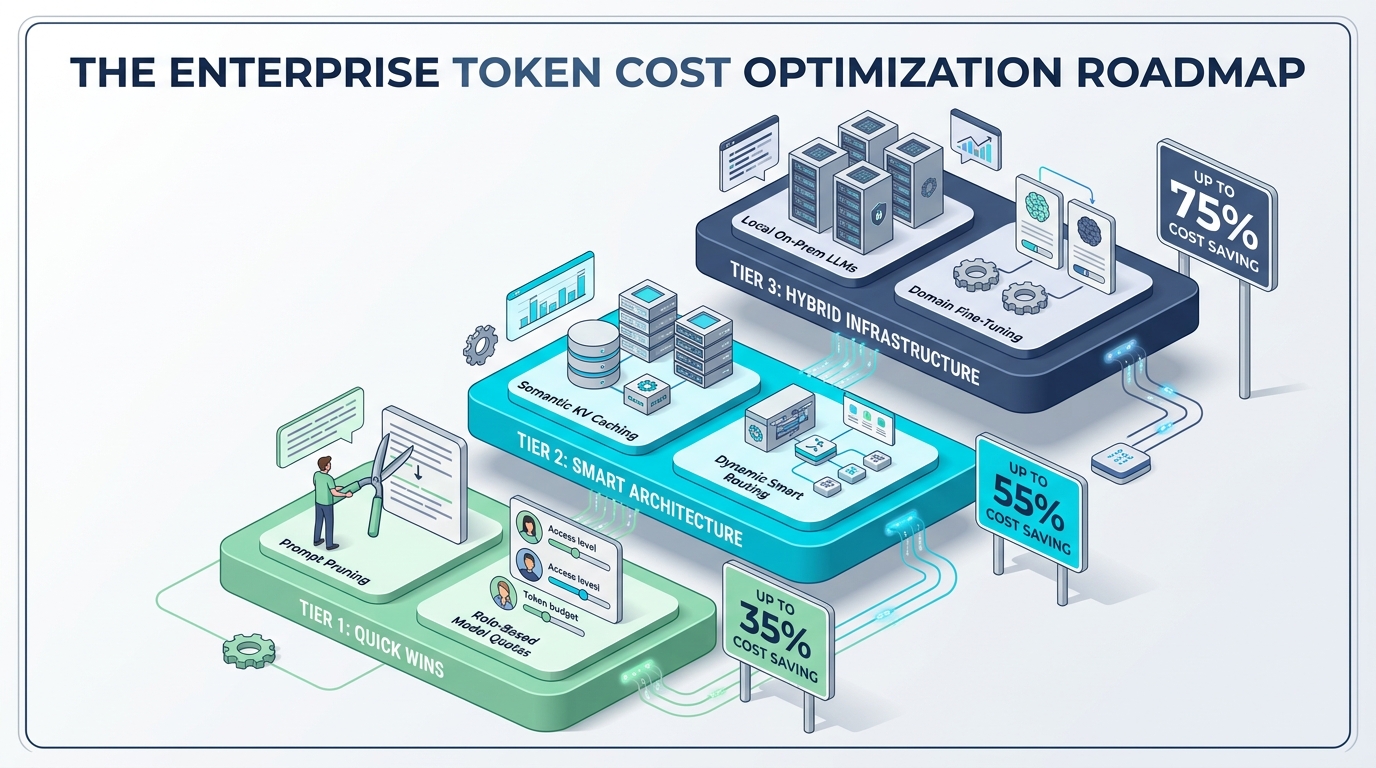
รูปภาพที่ 1: แผนผัง Roadmap บันได 3 ขั้นแห่งการควบคุมและลดต้นทุน Token ระดับองค์กร (Tier 1: Quick Wins ➔ Tier 2: Smart Architecture ➔ Tier 3: Hybrid Infrastructure)
🟢 ระดับที่ 1: Quick Wins (เริ่มได้ทันที ไม่ต้องแตะโครงสร้างพื้นฐาน)
ทำได้ภายใน 1 - 3 วัน ไม่ต้องลงทุนฮาร์ดแวร์ใหม่ ช่วยประหยัดงบได้ทันที 20 - 35%
เทคนิคที่ 1: Prompt Pruning & Context Compression (การตัดทอนและบีบอัด Prompt)
หนึ่งในสาเหตุที่ทำให้ค่าใช้จ่ายบานปลายที่สุดคือ "ขยะในบริบท (Context Bloat)" โดยเฉพาะการส่งประวัติแชตย้อนหลังทั้งหมด (Full Chat History) หรือการโยนเอกสาร PDF ทั้งเล่ม 100 หน้าเข้าไปใน Prompt ทุกครั้งที่มีการสนทนา
แนวทางปฏิบัติเพื่อประหยัด Token:
- ใช้เทคนิค Sliding Window Context: บันทึกและส่งต่อเฉพาะบทสนทนา 3 - 5 รอบล่าสุด แทนที่จะส่งประวัติการคุยตั้งแต่เริ่มแรก ซึ่งช่วยตัดทอน Input Tokens ลงได้มากกว่า 60%
- บังคับ Structured Output (JSON Schema): ในงานสกัดข้อมูล ให้สั่งให้ AI ตอบผลลัพธ์ในรูปแบบ JSON ที่มี Field ชัดเจน ป้องกันไม่ให้ AI ตอบคำทักทาย อารัมภบท หรือคำอธิบายยืดยาวที่ผลาญ Output Tokens โดยเปล่าประโยชน์
- Optimize RAG Chunking: ดึงเฉพาะย่อหน้าที่ตรงกับคำถามจริง (Top-k Relevant Chunks) แทนการดึงเอกสารมาทั้งหน้า
เทคนิคที่ 2: Role-Based Model Quotas & Tiered Access (จำกัดสิทธิ์โมเดลแพงตามบทบาท)
ในองค์กรส่วนใหญ่ มักปล่อยให้พนักงานทุกคนเข้าถึงโมเดลตัวท็อปราคาแพงได้เท่ากันหมด ทั้งที่ 80% ของงานในชีวิตประจำวันไม่จำเป็นต้องใช้พลังคำนวณระดับนั้น
แนวทางปฏิบัติเพื่อประหยัด Token:
- Executive & R&D Tier: กำหนดสิทธิ์ให้เฉพาะผู้บริหารระดับสูง, นักวิเคราะห์การเงิน, หรือทีมวิจัยพัฒนา เข้าถึง Flagship Models (เช่น GPT-4o, Claude 3.5 Sonnet) สำหรับงานวางแผนกลยุทธ์, การเจรจาการค้า, หรืองานวิเคราะห์ข้อมูลเชิงลึก
- Operational Tier: สำหรับพนักงานทั่วไปในฝ่ายสนับสนุน, ฝ่ายบริการลูกค้า, หรือธุรการ ให้กำหนดค่าเริ่มต้นเป็นโมเดลกลุ่ม Efficient (เช่น GPT-4o-mini, Claude 3.5 Haiku, Gemini Flash) ซึ่งมีราคาถูกกว่าโมเดลตัวท็อปถึง 10 - 20 เท่า แต่มีความสามารถในการสรุปความ ตอบคำถาม และตรวจไวยากรณ์ได้อย่างยอดเยี่ยม
- ตั้ง Token Budget Cap รายแผนก: วางเพดานงบประมาณค่า Token ประจำเดือน หากแผนกใดใช้ครบโควตา ระบบจะตัดสลับเป็นโมเดลประหยัดอัตโนมัติ (เชื่อมโยงกับ เสาหลักที่ 5: Centralized Resource Catalog & Control Plane)
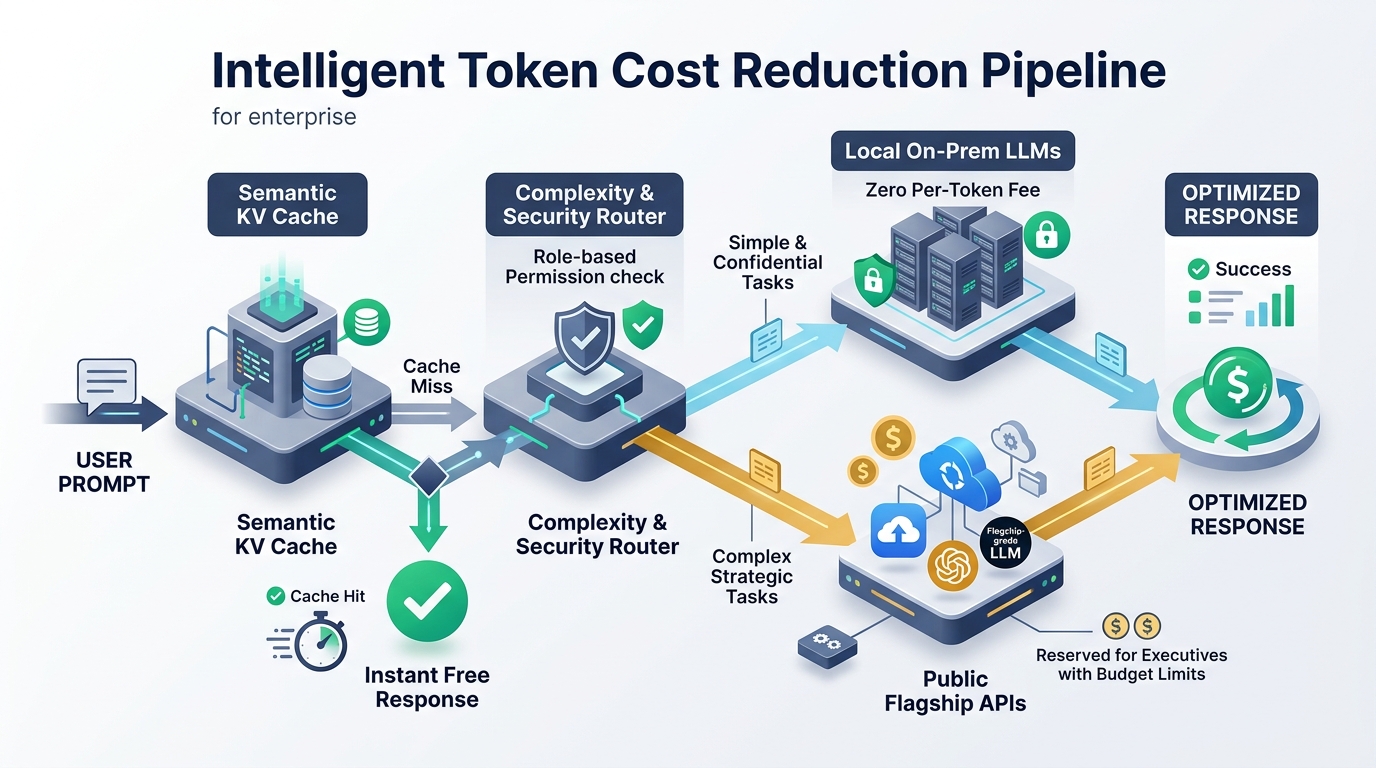 รูปภาพที่ 2: ไดอะแกรมแสดงขั้นตอนการทำงานของ Intelligent Token Pipeline ตั้งแต่ Semantic KV Cache, Complexity Router สู่ Local LLMs และ Public Flagship APIs
🔵 ระดับที่ 2: Smart Architecture (ยกระดับระบบ Middleware & Caching)
ปรับปรุงชั้น Middleware หรือ API Gateway ช่วยลดต้นทุนสะสมได้ 40 - 55%
เทคนิคที่ 3: Semantic KV Caching & Prompt Caching (การแคชคำตอบและบริบทเดิม)
ในสภาพแวดล้อมการทำงานระดับองค์กร พนักงานมักมีคำถามที่คล้ายคลึงกัน หรือต้องอ้างอิงเอกสารชุดเดียวกันซ้ำๆ (เช่น นโยบายเบิกจ่ายสวัสดิการ, คู่มือพนักงาน, Template สัญญาทางกฎหมาย) การส่งเอกสารชุดเดิมให้ AI ประมวลผลใหม่ทุกครั้งคือการเผาเงินโดยใช่เหตุ
แนวทางปฏิบัติเพื่อประหยัด Token:
- Prompt Caching: แคช System Prompt, คู่มือกฎระเบียบ, และเอกสาร RAG ขนาดใหญ่ที่ใช้บ่อยไว้ในหน่วยความจำ ช่วยลดค่าใช้จ่าย Input Token ของเอกสารเหล่านั้นลงได้ถึง 50 - 80%
- Semantic Caching: ระบบจะแปลงคำถามเป็นเวกเตอร์เพื่อตรวจจับความหมาย ตัวอย่างเช่น หากพนักงานคนหนึ่งถามว่า "สิทธิประกันกลุ่มเบิกค่ารักษาฟันได้เท่าไหร่" แล้วมีพนักงานอีกคนถามว่า "ทำฟันเบิกประกันบริษัทได้กี่บาท" ระบบจะตรวจพบว่าทั้งสองคำถามมีความหมายเดียวกัน และดึงคำตอบเดิมที่แคชไว้ส่งให้ทันที โดยไม่ต้องยิงคำสั่งไปหา LLM อีกรอบ (ค่า Token = 0 บาท และได้คำตอบเร็วระดับ Millisecond)
เทคนิคที่ 4: Dynamic Smart Routing & Model Cascading (การคัดแยกเส้นทางโมเดลอัจฉริยะ)
ไม่มีโมเดล AI ตัวใดตัวหนึ่งที่เหมาะกับงานทุกประเภทในองค์กร เทคนิค Smart Routing คือการติดตั้งระบบคัดแยกเส้นทางอัตโนมัติ (LLM Router) ที่คอยวิเคราะห์ความซับซ้อนของคำถามก่อนส่งต่อไปยังโมเดลที่เหมาะสมที่สุด
แนวทางปฏิบัติเพื่อประหยัด Token:
- Model Cascading (บันไดเลื่อนโมเดล): เมื่อมีคำขอส่งเข้ามา ให้โมเดลตัวเล็กราคาถูกประมวลผลก่อน หากผลลัพธ์ผ่านเกณฑ์ความมั่นใจ (Confidence Score) ให้ส่งมอบคำตอบทันที แต่หากงานมีความซับซ้อนสูงหรือโมเดลตัวเล็กไม่มั่นใจ ระบบจะส่งต่อ (Escalate) ไปยังโมเดลตัวใหญ่โดยอัตโนมัติ
- Security & Classification Router: ระบบจะสแกนเนื้อหาใน Prompt หากตรวจพบว่าเป็นข้อมูลความลับทางการค้า หรือข้อมูลส่วนบุคคล (PII ตาม PDPA) ระบบจะบังคับส่งไปประมวลผลบน Local Model ภายในองค์กรโดยอัตโนมัติ เพื่อความปลอดภัยและประหยัดต้นทุน (เชื่อมโยงกับ เสาหลักที่ 4: Token Factory & Cost Optimization)
🟣 ระดับที่ 3: Hybrid Infrastructure Transformation (โครงสร้างพื้นฐานระยะยาวแบบยั่งยืน)
การลงทุนวางระบบในระดับสถาปัตยกรรมองค์กร ช่วยลดต้นทุนในระยะยาวได้สูงสุดถึง 70 - 75%
เทคนิคที่ 5: Local On-Premise Open-Source Models (ติดตั้งโมเดลภายในองค์กร)
สำหรับงานประจำวันที่มีปริมาณธุรกรรมมหาศาล (High-Volume Repetitive Tasks) เช่น การอ่านและตรวจเช็กความถูกต้องของใบแจ้งหนี้, การคัดแยกตั๋วบริการลูกค้า (Customer Support Tickets), หรือการแปลงไฟล์เสียงบันทึกการประชุมเป็นข้อความ หากพึ่งพา Public Cloud API องค์กรจะต้องจ่ายค่า Token ต่อเนื่องทุกวันไม่รู้จบ
แนวทางปฏิบัติเพื่อประหยัด Token:
- นำโมเดล Open-Weight ระดับโลก เช่น Llama 3.1 / 3.3, DeepSeek, หรือ Qwen มาติดตั้งบน GPU Cluster ภายใน Data Center ขององค์กร
- ต้นทุนต่อ Transaction เป็น 0 บาท: เมื่อลงทุนฮาร์ดแวร์ครั้งเดียว องค์กรสามารถรันคำถามกี่ล้าน Transaction ก็ได้โดยไม่มีบิลค่า Token รายเดือนตามมา จ่ายเพียงค่าไฟและค่าบำรุงรักษาเซิร์ฟเวอร์ที่ควบคุมได้แน่นอน แถมยังการันตีว่าข้อมูลความลับขององค์กรจะไม่หลุดรอดออกสู่คลาวด์ภายนอก 100%
เทคนิคที่ 6: Small Language Models (SLMs) & Domain Fine-Tuning (เทรนโมเดลเฉพาะทางขนาดกะทัดรัด)
แนวโน้มของ AI ระดับองค์กรในปัจจุบันกำลังเปลี่ยนผ่านจากโมเดลขนาดยักษ์ (70B - 400B Parameters) สู่โมเดลขนาดกะทัดรัดแต่เชี่ยวชาญเฉพาะทาง (Small Language Models: 3B - 14B Parameters)
แนวทางปฏิบัติเพื่อประหยัด Token:
- นำโมเดลขนาดเล็กมาทำ Domain Fine-Tuning ด้วยชุดข้อมูล, พจนานุกรมศัพท์เฉพาะ, และกฎระเบียบขององค์กร (เช่น กฎหมายภาษีไทย, ระเบียบการจัดซื้อ, หรือประวัติการซ่อมบำรุงเครื่องจักร)
- ผลลัพธ์ที่ได้: โมเดลขนาดเล็กที่ผ่านการ Fine-tune สามารถทำงานเฉพาะทางได้แม่นยำเท่ากับหรือดีกว่าโมเดลตัวยักษ์ แต่กินทรัพยากรการคำนวณน้อยกว่าถึง 10 เท่า ตอบสนองเร็วกว่าหลายเท่าตัว และรันบนฮาร์ดแวร์ราคาประหยัดได้สบาย
📊 ตารางสรุปเปรียบเทียบ: 6 เทคนิคการคุมต้นทุน Token
| ลำดับ | เทคนิค | ระดับความยาก | ระยะเวลาทำ | สัดส่วนการลดต้นทุน | เหมาะกับใคร |
|---|---|---|---|---|---|
| 1 | Prompt Pruning & Schema Output | ง่ายมาก | 1 - 2 วัน | 10 - 20% | ทุกโปรเจกต์ AI ในองค์กร |
| 2 | Role-Based Model Quotas | ง่าย | 2 - 3 วัน | 20 - 35% | ทุกองค์กรที่มีผู้ใช้งานหลายแผนก |
| 3 | Semantic KV & Prompt Caching | ปานกลาง | 1 - 2 สัปดาห์ | 40 - 55% | องค์กรที่มีเอกสาร RAG และคำถามซ้ำบ่อย |
| 4 | Dynamic Smart Routing | ปานกลาง | 2 - 3 สัปดาห์ | 50 - 60% | องค์กรที่ใช้ทั้งโมเดลขนาดเล็กและใหญ่ |
| 5 | Local On-Premise LLMs | ขั้นสูง | 3 - 4 สัปดาห์ | 60 - 75% | องค์กรที่มีข้อมูลลับและปริมาณธุรกรรมสูง |
| 6 | Domain SLMs Fine-Tuning | ขั้นสูง | 4 - 6 สัปดาห์ | 70 - 75%+ | องค์กรที่ต้องการความแม่นยำในงานเฉพาะทาง |
🤝 AuthorWise: Strategic AI FinOps & Architecture Partner
การควบคุมต้นทุน Token ไม่ใช่การจำกัดไม่ให้พนักงานใช้งาน AI แต่คือการ "วางระบบบริหารจัดการที่ทำให้ทุก Token ที่จ่ายไป สร้างผลตอบแทนทางธุรกิจ (ROI) สูงสุด"
ที่ AuthorWise ในฐานะ Enterprise AI Implementation & Governance Partner เราพร้อมช่วยให้องค์กรของคุณปรับใช้ทั้ง 6 เทคนิคนี้อย่างเป็นรูปธรรม:
- ⚙️ Turnkey Token Factory & Smart Routing Setup: ติดตั้งระบบควบคุมการจ่าย Token ศูนย์กลาง พร้อมเทคโนโลยี Semantic KV Caching และ Auto-Routing สลับโมเดลอัตโนมัติ
- 🖥️ Private GPU & Local LLM Deployment: ติดตั้งและปรับแต่งโมเดล Open-Source (Llama, DeepSeek, Qwen) บนโครงสร้างพื้นฐานภายในองค์กรของคุณอย่างปลอดภัย
- 🛡️ Role-Based Governance & Quota Metering: วางระบบบริหารสิทธิ์ RBAC และระบบจัดสรรโควตารายแผนก ป้องกันปัญหางบบานปลาย 100%
- 🔄 Enterprise Workflow Integration: เชื่อมต่อท่อส่ง Token ประสิทธิภาพสูงเข้ากับระบบงานอัตโนมัติ Joget DX Enterprise Workflows ผ่านทีมงาน AI Integration Specialist
พร้อมเปลี่ยนบิลค่าใช้จ่าย AI ให้เป็นการลงทุนที่คุ้มค่าและควบคุมได้แล้วหรือยัง?
✉️ ปรึกษาทีม AI Architect และ FinOps Specialist ของ AuthorWise ได้แล้ววันนี้ที่ ติดต่อทีมงาน AuthorWise หรืออีเมล contact@authorwise.co.th