ประเมินก่อนเจ็บจริง! วิธีแปลง Workload องค์กรเป็น Token: คำนวณอย่างไรให้รู้ล่วงหน้าว่าต้องจ่ายเดือนละกี่บาท?
ผู้เขียน: ทีมยุทธศาสตร์สถาปัตยกรรมดิจิทัลและการเงินไอที (AI FinOps) AuthorWise
หมวดหมู่: AI FinOps, Enterprise Architecture, Cost Optimization, IT Governance
กลุ่มเป้าหมาย: CFO, CIO, CTO, Enterprise Architects, IT Directors, Heads of AI/Data, Innovation Leaders
ในห้องประชุมบอร์ดบริหาร เมื่อฝ่ายนวัตกรรมหรือทีมไอทีเสนอของบประมาณในการนำ Generative AI เข้ามาใช้งานในองค์กร คำถามคลาสสิกที่ CFO (ประธานเจ้าหน้าที่บริหารฝ่ายการเงิน) และ CIO (ประธานเจ้าหน้าที่บริหารฝ่ายสารสนเทศ) มักถามกลับมาเป็นอันดับแรกคือ:
"ถ้าเราเปิดให้พนักงาน 1,000 คนใช้งาน หรือนำมาอ่านใบแจ้งหนี้เดือนละ 10,000 ใบ สิ้นเดือนบริษัทจะต้องจ่ายเงินค่า AI เดือนละกี่บาท?"
คำถามนี้ฟังดูเรียบง่าย แต่ในทางปฏิบัติกลับเป็นหนึ่งในคำถามที่สร้าง "ความอึดอัดใจ" ให้กับทีมพัฒนามากที่สุด...
เพราะในฝั่งธุรกิจ เราคิดเป็นรูปธรรม เช่น จำนวนคน, จำนวนครั้งที่คลิก, หรือจำนวนหน้ากระดาษ... แต่ในฝั่งผู้ให้บริการโมเดล AI (เช่น OpenAI, Anthropic, Google, Microsoft) กลับส่งใบแจ้งหนี้มาในหน่วย "Input Tokens และ Output Tokens ต่อล้านโทเค็น (Per 1 Million Tokens)"
ความไม่สอดคล้องระหว่างหน่วยวัดทางธุรกิจกับหน่วยวัดทางเทคนิคนี้ เรียกว่า "The Estimation Void (ช่องว่างแห่งการประเมิน)" ซึ่งหากองค์กรไม่มีสูตรคำนวณที่แม่นยำ มักจะนำไปสู่ความผิดพลาด 2 รูปแบบ:
- ประเมินต่ำเกินจริง (Underestimating): คิดว่างบคงแค่หลักพันหลักหมื่น แต่พอขึ้นระบบ Production จริง บิลกลับพุ่งแตะหลักแสนหลักล้านจนเกิดภาวะ "บิลช็อก (Surprise Bill)"
- ประเมินไม่เป็นจนกลัว (Fear of Unknown Cost): ผู้บริหารไม่กล้าอนุมัติงบเพราะมองไม่เห็นเพดานค่าใช้จ่าย ทำให้โครงการดิจิทัลที่ควรสร้างแต้มต่อทางธุรกิจต้องหยุดชะงักลง
ในบทความนี้ AuthorWise จะมาเปิดเผย "กรอบการประเมิน 4 ขั้นตอน (The 4-Step AI Token Estimation Framework)" พร้อมสูตรตัวคูณภาษาไทย และการจำลองเคสคำนวณจริงเป็นเงินบาท (THB) ให้ผู้บริหารเห็นตัวเลขชัดเจนก่อนตัดสินใจลงทุน
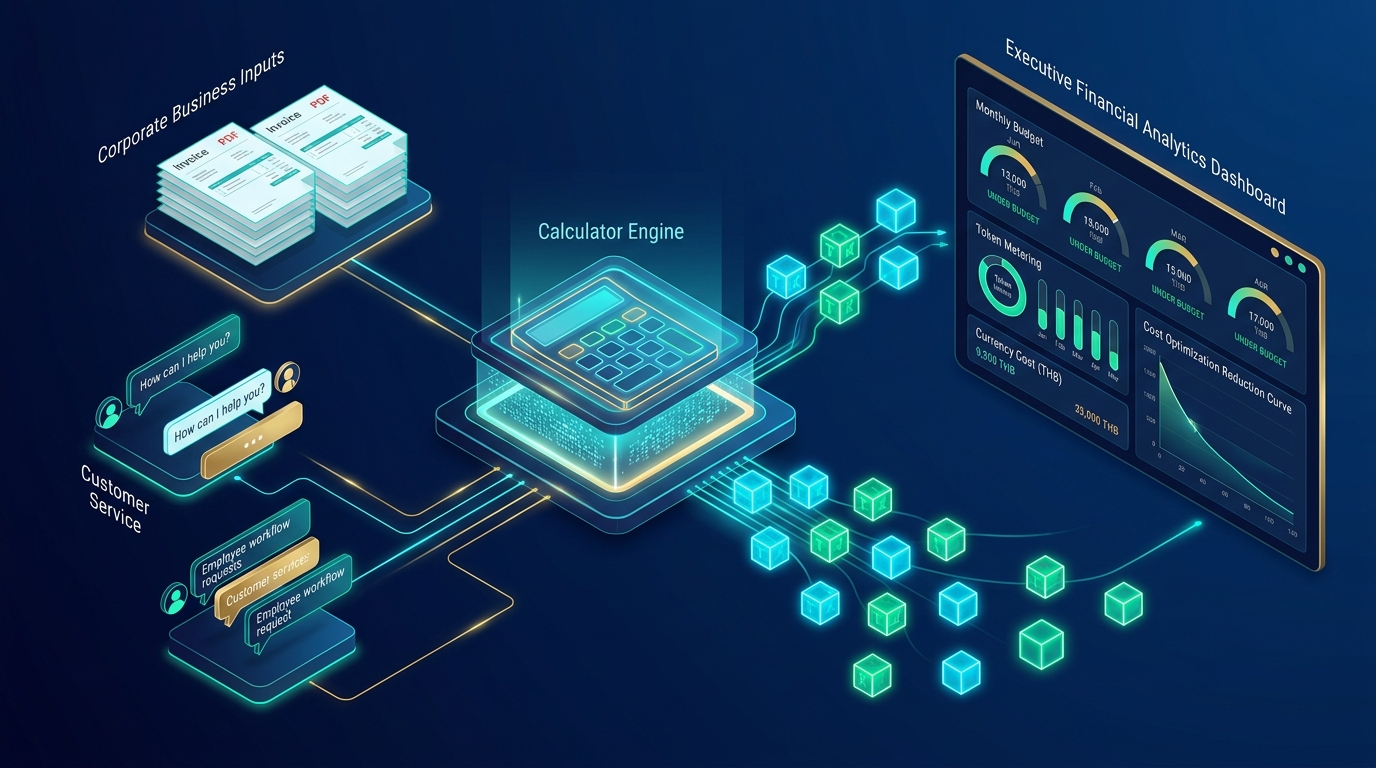
รูปภาพที่ 1: ภาพจำลองกระบวนการแปลงจาก Workload ธุรกิจ (เอกสาร, แชต, ระบบงาน) ผ่านเครื่องมือคำนวณสถาปัตยกรรม สู่การแสดงผลงบประมาณและเพดานควบคุมต้นทุนในแดชบอร์ดการเงิน
🔤 ทำความเข้าใจรากฐาน: Token คืออะไร และทำไมภาษาไทยถึงกิน Token เปลืองกว่า?
ก่อนจะไปถึงสูตรคำนวณ เราต้องเข้าใจก่อนว่า "Token (โทเค็น)" ไม่ใช่จำนวนคำ (Words) และไม่ใช่จำนวนตัวอักษร (Characters) แต่คือ "ชิ้นส่วนของคำ (Sub-word Fragments)" ที่อัลกอริทึมตัดคำ (Tokenizer) ของโมเดลใช้ในการอ่านและทำความเข้าใจ
⚠️ กับดักตัวคูณภาษาไทย (The Thai Token Multiplier)
โมเดล AI ส่วนใหญ่ในโลกถูกฝึกฝน (Train) บนชุดข้อมูลภาษาอังกฤษเป็นหลัก Tokenizer จึงถูกออกแบบให้จำคำศัพท์ภาษาอังกฤษได้ทั้งคำหรือตัดเป็นชิ้นส่วนใหญ่ๆ:
- ภาษาอังกฤษ: 1 คำ (Word) จะคิดเป็นประมาณ 1.2 - 1.3 Tokens
- ภาษาไทย: เนื่องจากภาษาไทยเขียนติดกันไม่มีวรรคตอน และมีสระบน-ล่าง-หน้า-หลัง วรรณยุกต์จำนวนมาก Tokenizer ของ AI จึงต้องหั่นคำภาษาไทยออกเป็นชิ้นเล็กๆ ระดับไบต์ ทำให้ 1 คำภาษาไทย ต้องใช้มากถึง 2.5 - 3.5 Tokens!
📌 กฎทองจำง่ายของ AuthorWise:
ในบริบทงานเอกสารภาษาไทยขององค์กร "เอกสาร A4 พิมพ์ข้อความมาตรฐาน 1 หน้า (ประมาณ 350-400 คำไทย) จะกินพลังงานประมาณ 1,000 - 1,400 Tokens!"
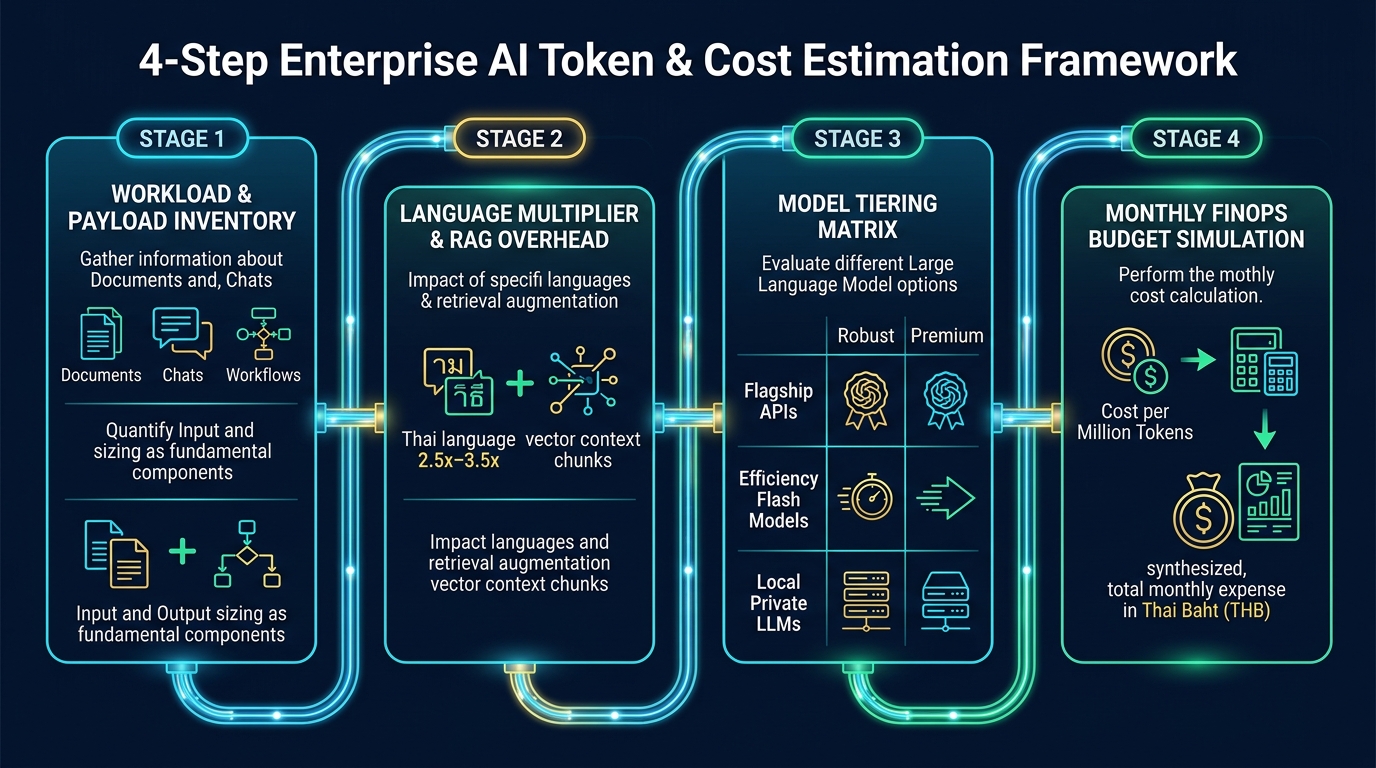 รูปภาพที่ 2: ผังกระบวนการประเมิน 4 ขั้นตอน: จากการสำรวจภาระงาน (Workload) ➔ คำนวณตัวคูณภาษาและ RAG Overhead ➔ แมตช์ตารางราคาโมเดล ➔ สรุปจำลองงบประมาณประจำเดือน (THB)
📐 กรอบการประเมิน 4 ขั้นตอน (The 4-Step Estimation Framework)
เพื่อให้องค์กรสามารถทำนายตัวเลขค่าใช้จ่ายได้อย่างแม่นยำ AuthorWise ได้สรุปแนวทางการประเมินออกเป็น 4 ขั้นตอนดังนี้:
ขั้นตอนที่ 1: วัดขนาดภาระงาน (Workload & Payload Inventory)
แยกวิเคราะห์ภาระงานออกเป็น 2 ฝั่งอย่างชัดเจนเสมอ:
- Input Payload (ข้อมูลขาเข้า): ประกอบด้วย 3 ส่วน
- System Prompt: คำสั่งตั้งต้นของระบบ (เช่น บทบาท กฎความปลอดภัย เงื่อนไขการตอบ)
- User Prompt: คำถามหรือข้อความที่พนักงาน/ลูกค้าพิมพ์ส่งเข้ามา
- Context / Retrieved Documents: ข้อมูลอ้างอิงที่ระบบดึงมาจากฐานข้อมูล (เช่น ข้อความที่ตัดมาจากระเบียบบริษัท หรือเนื้อหาจาก PDF)
- Output Payload (ข้อมูลขาออก): คำตอบที่ต้องการให้ AI สร้างออกมา (เช่น สรุปเนื้อหา 5 บรรทัด, ร่างอีเมลตอบกลับ, หรือข้อความ JSON Data)
- Volume (ปริมาณการทำงาน): จำนวนธุรกรรม (Transactions) ต่อวัน และจำนวนวันทำงานต่อเดือน
ขั้นตอนที่ 2: คำนวณ RAG Overhead & Context Bloat
ในระบบ AI องค์กร (เช่น Chatbot ถามตอบระเบียบบริษัท) ความเข้าใจผิดที่พบบ่อยที่สุดคือการคิดว่า Input Token เท่ากับความยาวคำถามของพนักงาน (เช่น ถามว่า "ค่ารักษาพยาบาลเบิกได้กี่บาท" = 15 tokens)
แต่ในความเป็นจริง: ระบบ RAG (Retrieval-Augmented Generation) จะต้องไปค้นหาเอกสารที่เกี่ยวข้องในคลังข้อมูล แล้วหยิบข้อความอ้างอิงแนบเข้าไปใน Prompt อีก 3 - 5 ย่อหน้า (เรียกว่า Chunks)
- คำถามพนักงาน: ~20 tokens
- System Instruction: ~300 tokens
- RAG Context ที่ระบบดึงมาแนบ: ~1,500 - 2,500 tokens!
- สรุป Input รวมจริงต่อ 1 ครั้ง = 1,800 - 2,800 tokens! (มากกว่าที่คิดไว้กว่า 100 เท่า)
ขั้นตอนที่ 3: จับคู่กับ Model Tiering Matrix (ตารางราคาโมเดล)
ราคาของผู้ให้บริการ AI คิดเป็น USD ต่อ 1 ล้านโทเค็น (Per 1M Tokens) โดยราคาของ Output Token จะแพงกว่า Input Token ประมาณ 3 - 5 เท่าเสมอ เพราะการสร้างคำตอบต้องใช้พลังคำนวณสูงกว่าการอ่าน
ตารางเปรียบเทียบราคาโมเดลยอดนิยม (อ้างอิงอัตราแลกเปลี่ยน 1 USD ≈ 35 บาท):
| ระดับโมเดล (Tier) | ตัวอย่างโมเดล | ราคา Input / 1M Tokens | ราคา Output / 1M Tokens | จุดเด่นและงานที่เหมาะสม |
|---|---|---|---|---|
| Flagship Tier | GPT-4o, Claude 3.5 Sonnet | $2.50 - $3.00 (~88 - 105 บาท) | $10.00 - $15.00 (~350 - 525 บาท) | งานวางแผนกลยุทธ์, วิเคราะห์สัญญาซับซ้อน, เขียนโค้ดขั้นสูง |
| Mid / Efficient Tier | GPT-4o-mini, Claude 3.5 Haiku, Gemini 1.5 Flash | $0.15 - $0.25 (~5 - 9 บาท) | $0.60 - $1.25 (~21 - 44 บาท) | บอทบริการลูกค้า, ถามตอบ HR, สกัดเอกสาร, จัดหมวดหมู่อีเมล |
| Local Private LLM | Llama 3.3 70B, Qwen 2.5 บน GPU ขององค์กร | 0 บาท (ไม่มีค่า API ต่อ Token) | 0 บาท (ไม่มีค่า API ต่อ Token) | งานประมวลผลข้อมูลความลับ, ธุรกรรมปริมาณมหาศาล (High Volume) |
ขั้นตอนที่ 4: รวมสมการคำนวณงบประมาณ (The Monthly Budget Formula)
💼 ตัวอย่างคำนวณจริง 3 กรณีศึกษาในองค์กร (Real Enterprise Scenarios)
เพื่อให้เห็นภาพที่ชัดเจน มาดูการจำลองตัวเลขจริงจาก 3 Use Case ยอดนิยมในองค์กรไทย:
กรณีศึกษาที่ 1: ระบบ AI ถามตอบระเบียบพนักงาน (HR Policy Assistant)
- บริบท: องค์กรมีพนักงาน 1,000 คน ถามคำถามเฉลี่ยคนละ 2 ครั้งต่อวัน (ทำงาน 22 วัน/เดือน)
➔ Volume รวม = 44,000 Transactions ต่อเดือน - ขนาด Payload ต่อ 1 คำถาม:
- Input Payload: (คำถามพนักงาน + System Prompt + RAG Context เอกสาร HR) = เฉลี่ย 1,800 Tokens
- Output Payload: (คำตอบสรุปพร้อมข้อปฏิบัติจาก AI) = เฉลี่ย 300 Tokens
- ปริมาณ Token สะสมต่อเดือน:
- Input Tokens รวม: 44,000 ครั้ง × 1,800 Tokens = 79.2 ล้าน Tokens (79.2M)
- Output Tokens รวม: 44,000 ครั้ง × 300 Tokens = 13.2 ล้าน Tokens (13.2M)
💰 เปรียบเทียบผลลัพธ์งบประมาณ:
- ทางเลือก A (ขี่ช้างจับตั๊กแตน - ใช้ Flagship Model GPT-4o):
- ค่า Input Tokens: 79.2M × $2.50 × 35 บาท = 6,930 บาท
- ค่า Output Tokens: 13.2M × $10.00 × 35 บาท = 4,620 บาท
- ❌ รวมจ่ายต่อเดือน = 11,550 บาท (~138,600 บาท/ปี)
- ทางเลือก B (เลือกโมเดลตรงสเปก - ใช้ Efficient Model GPT-4o-mini):
- ค่า Input Tokens: 79.2M × $0.15 × 35 บาท = 415.80 บาท
- ค่า Output Tokens: 13.2M × $0.60 × 35 บาท = 277.20 บาท
- ✅ รวมจ่ายต่อเดือน = 693 บาท (~8,316 บาท/ปี)
- 🎉 ประหยัดงบได้ทันที 94% โดยที่พนักงานแทบไม่รู้สึกถึงความแตกต่างของคำตอบ!
กรณีศึกษาที่ 2: ระบบ AI สกัดข้อมูลใบแจ้งหนี้เข้า ERP (Intelligent Invoice Extraction)
- บริบท: บริษัทอ่านเอกสารใบเสร็จ/ใบแจ้งหนี้ PDF เดือนละ 10,000 ฉบับ
- ขนาด Payload ต่อ 1 ฉบับ:
- Input Payload: (เอกสารใบแจ้งหนี้เฉลี่ย 2 หน้า A4 + คำสั่ง Schema) = เฉลี่ย 2,500 Tokens
- Output Payload: (ข้อมูลโครงสร้าง JSON ส่งเข้า ERP) = เฉลี่ย 400 Tokens
- ปริมาณ Token สะสมต่อเดือน:
- Input Tokens รวม: 10,000 ฉบับ × 2,500 Tokens = 25 ล้าน Tokens (25M)
- Output Tokens รวม: 10,000 ฉบับ × 400 Tokens = 4 ล้าน Tokens (4M)
💰 ผลลัพธ์งบประมาณ:
- หากใช้ Claude 3.5 Haiku:
- ค่า Input Tokens: 25M × $0.25 × 35 บาท = 218.75 บาท
- ค่า Output Tokens: 4M × $1.25 × 35 บาท = 175.00 บาท
- ✅ รวมค่า Token ทั้งสิ้นเพียงประมาณ 393.75 บาทต่อเดือน เพื่อแลกกับการไม่ต้องจ้างคนมานั่งคีย์ข้อมูล 10,000 ใบ (ROI สูงมหาศาล!)
กรณีศึกษาที่ 3: ระบบ Autonomous AI Agent ในการจัดซื้อ (Multi-Agent Workflow)
- บริบท: กระบวนการจัดซื้อที่ต้องให้ Agent 3 ตัวทำงานร่วมกัน (ตัวที่ 1 ตรวจสอบใบขอซื้อ PR ➔ ตัวที่ 2 เปรียบเทียบราคาคู่ค้า ➔ ตัวที่ 3 ร่างเอกสารอนุมัติ PO)
- ความท้าทาย: Agent ทำงานวนลูปหลายรอบ (Multi-turn Loop) ส่งผลให้ Input Token ทวีคูณขึ้นเรื่อยๆ ตามประวัติการคิด (Chain-of-Thought)
- การคำนวณ: งาน 1 เคสอาจใช้ Input สะสมถึง 15,000 Tokens! หากมี 2,000 เคสต่อเดือน = 30M Tokens
- คำแนะนำ: งานลักษณะนี้หากส่งคลาวด์ล้วนจะสิ้นเปลืองมาก ควรใช้สถาปัตยกรรม Hybrid โดยให้ Agent ตัวคัดกรองเบื้องต้นรันบน Local LLM ภายในองค์กร และส่งเฉพาะขั้นตอนสรุปสุดท้ายไปยัง Cloud Model
💡 3 เทคนิคสถาปัตยกรรมที่ช่วยหักลดงบ Token ลงอีก 50–75%
เมื่อคำนวณตัวเลขฐานออกมาแล้ว องค์กรยังสามารถลดงบประมาณลงได้อีกมหาศาลด้วยการออกแบบระบบที่ดี:
- ติดตั้ง Semantic KV Caching:
คำถามเกี่ยวกับระเบียบบริษัทกว่า 70% มักเป็นคำถามซ้ำๆ การมีระบบ Semantic Cache จะช่วยดักคำถามที่มีความหมายเหมือนกันและตอบกลับทันที โดยไม่ส่งไปคิดเงินที่ API ทำให้ประหยัดค่า Input Token ลงได้ 60–80% - บังคับ Output แบบ Structured JSON แทน Free-Text:
การสั่งให้โมเดลตอบเฉพาะรหัส JSON สั้นๆ แทนการพิมพ์คำทักทายและข้อความอารัมภบท จะช่วยตัดทอน Output Token (ซึ่งเป็นส่วนที่แพงที่สุด) ลงได้เกินครึ่ง - วางระบบ Smart Routing ร่วมกับ Enterprise Token Factory:
ใช้ระบบศูนย์กลางคอยคัดแยกความยากง่ายของงาน งานง่ายส่งไปโมเดลราคาถูกหรืองานซ้ำตอบจากแคช ทำให้องค์กรควบคุมงบประมาณได้แบบ 100% ปลอดภัยจากบิลช็อก
🎯 สรุป: ให้ AuthorWise ช่วยทำ AI Workload & Token Assessment ให้องค์กรของคุณ
การเริ่มต้นโครงการ AI ในองค์กร ไม่จำเป็นต้องเริ่มแบบเดาสุ่ม และไม่ต้องเสี่ยงกับการลุ้นบิลตอนสิ้นเดือน
AuthorWise พร้อมช่วยองค์กรของคุณ:
- ประเมินปริมาณงานจริง (Workload Assessment): สำรวจกระบวนการทำงาน เอกสาร และจำนวน Transaction ในแต่ละแผนก
- ทำนายและคำนวณงบประมาณล่วงหน้า (Token & Cost Simulation): แปลงงานเป็นตัวเลข Token และจำลองค่าใช้จ่ายจริงในแต่ละสถาปัตยกรรม
- ออกแบบสถาปัตยกรรม Hybrid & Token Factory: ติดตั้งระบบ Gateway, Smart Routing, และ Semantic Caching ช่วยลดงบประมาณ Token สูงสุด 75%
- เชื่อมต่อระบบงานอย่างปลอดภัยด้วย Joget DX (Low-Code & AI Governance): สร้างแอปพลิเคชันและเวิร์กโฟลว์อัตโนมัติที่คุ้มค่า ปลอดภัย และวัดผล ROI ทางธุรกิจได้จริง
💡 อยากรู้ว่าระบบงานในองค์กรของคุณ แปลงเป็น Token แล้วต้องจ่ายเดือนละกี่บาท?
ปรึกษาและให้ทีมสถาปัตยกรรม AI ของ AuthorWise ช่วยประเมินได้แล้ววันนี้
📞 โทร: 081-555-6615
✉️ อีเมล: auttakorn.ph@authorwise.co.th
🌐 เว็บไซต์: www.authorwise.co.th